In einem anderen Artikel habe ich bereits beschrieben, wie ich mit Claude Code Spec-driven Development betreibe: erst eine Spezifikation, dann Arbeitspakete, dann pro Issue eine feste Kette aus Konzeption, Umsetzung, Test und Review. In diesem Artikel zeige ich euch, warum ich diesen Ablauf jetzt deutlich verschlankt habe und was sich dadurch ändert.
Der Anlass war zweigeteilt. Die Läufe waren mir zu langsam und zu teuer geworden, und rund um die Kette war ein Mess- und Prüfapparat gewachsen, der selbst gepflegt werden wollte. Gleichzeitig ist eine neue Modellgeneration erschienen, für die viele meiner alten Absicherungen nicht mehr nötig sind.
Was sich angesammelt hatte
Mit jedem Problem, das mir in einem Lauf aufgefallen ist, kam eine Regel oder ein Werkzeug dazu. So entstanden eine Laufbilanz für jedes Issue, Skripte zur Auswertung dieser Bilanzen, Regressionstests für die Prüfer-Agenten und ein eigener Eval-Apparat mit gesammelten Testfällen. Die Kette konnte zeitweise sogar mehrere Issues parallel abarbeiten, mit Sperren und Nachziehen.
Jedes dieser Teile war für sich begründet. In der Summe habe ich aber immer mehr Zeit in die Pflege des Prozesses gesteckt statt in die Werkzeuge, die damit entstehen sollten. Die Anleitung des zentralen Skills /spec-run war auf rund 70 KB gewachsen, und auch die CLAUDE.md-Dateien meiner Projekte wurden mit jedem Vorfall länger.
Was die Zahlen gezeigt haben
Einen Vorteil hatte die Laufbilanz: Ich konnte nachsehen, was der Prozess tatsächlich leistet. Am 19. Oktober 2026 habe ich die Läufe aus sieben Projekt-Repositories ausgewertet:
| Kennzahl | Wert |
|---|---|
| Läufe insgesamt | 434 |
| davon gemergt | 383 |
| Dauer je Issue (Median, je Repository) | 1 bis 2,5 Stunden |
| Läufe im Direktmodus | 17 |
| Befunde des Konzept-Reviews, die das Konzept selbst betrafen | 82 % |
Die letzte Zeile hat mich am meisten beschäftigt. Von 691 Befunden betrafen 29 % den Testplan des Konzepts und weitere 53 % sonstige Fehler im Konzept, jeweils gefunden vom Konzept-Review. Der concept-reviewer hat also vor allem Fehler gefunden, die der architect kurz vorher selbst eingebaut hatte. Ob dieselben Fehler ohne Konzept überhaupt im Code gelandet wären und ob Test, Review und CI sie dort nicht ohnehin gefangen hätten, konnte mir keine Kennzahl sagen.
Gleichzeitig lief fast jedes Paket über den vollen Weg mit Konzeptphase. Den Direktmodus ohne Konzeptphase hatten nur 17 von 434 Läufen genutzt.
Neue Modelle, neue Ausgangslage
Im September kam eine neue Modellgeneration dazu. Anthropic hat am 22. September 2026 Claude Opus 5.5 veröffentlicht. Laut Hersteller arbeitet es bei den meisten Aufgaben auf dem Niveau von Fable 5.1 und kostet bei typischen Lasten 40 % weniger als Opus 5. Am 28. September folgte Claude Sonnet 5.5, mit einem besonders deutlichen Sprung beim Programmieren und bis zu 30 % weniger Kosten je Aufgabe.
Mein alter Ablauf war darauf ausgelegt, jedes Ergebnis mehrfach abzusichern. Mit den 5.5er-Modellen halte ich dieses Vorgehen für veraltet. Ich habe die Suite deshalb an die neuen Modelle angepasst und mich dabei an einem Grundsatz orientiert, den Anthropic in Building effective agents formuliert: die einfachste Lösung suchen und Komplexität nur dann hinzufügen, wenn sie das Ergebnis nachweislich verbessert.
In Version 3.0 habe ich deshalb die Laufbilanz, die Auswertungsskripte, den Prüfer-Regressionstest, den Eval-Apparat und den Parallelbetrieb entfernt. Die Kette arbeitet ihre Issues wieder nacheinander ab.
Drei Wege statt einem
Die wichtigste Änderung betrifft den Ablauf pro Issue. Die Komplexitätsklasse, die /spec-plan jedem Paket gibt, bestimmt jetzt den Weg durch die Kette:
| Klasse | Weg | Ablauf |
|---|---|---|
| mechanisch | Direktmodus | Der Orchestrator setzt selbst um und testet, danach folgt ein Review-Durchgang. |
| normal | leicht | Der implementer schreibt zuerst einen Kurzplan und setzt dann um, ohne architect und concept-reviewer. |
| schwierig | voll | Konzeptphase mit architect und concept-reviewer wie bisher. |
Ist die Klasse unklar oder doppelt angegeben, gilt schwierig. Alle drei Wege münden in dasselbe Review-Gate:
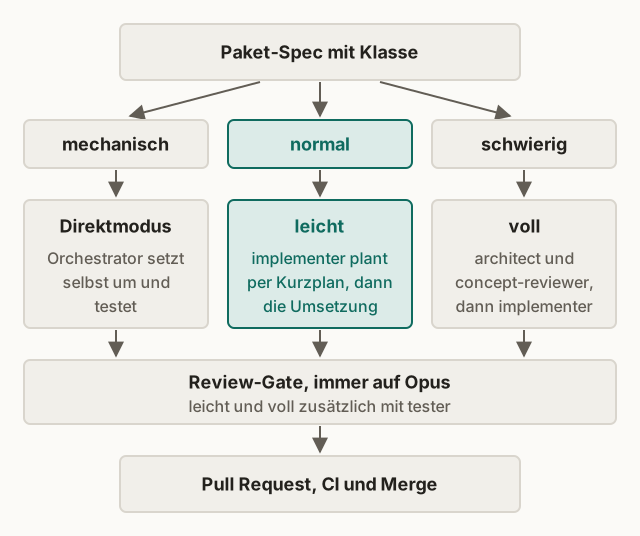
Der Kurzplan des leichten Wegs ist bewusst knapp. Er hat genau vier Abschnitte: betroffene Dateien, Randfälle und Fehlerverhalten, Testideen und Annahmen. Niemand prüft ihn vorab. tester und reviewer bekommen ihn mit dem ausdrücklichen Hinweis, dass er ungeprüft ist, und suchen Randfälle selbst gegen Paket-Spec und Diff.
Geht etwas schief, eskaliert der Lauf. Im Direktmodus wechselt er bei einem ernsten Befund in den leichten Weg. Im leichten und vollen Weg steigt bei einem roten Test oder einem ernsten Befund die betroffene Rolle von Sonnet auf Opus, falls sie nicht schon dort läuft. Eine Konzeptphase wird dabei nicht nachgeholt. An einer Stelle bleibe ich bei meiner alten Regel: Das Review-Gate läuft immer auf Opus. Gespart wird an der Konzeption, nie an der Prüfung.
Skripte statt Anleitungstext
Ein großer Teil der alten Anleitung beschrieb Schritte, die immer gleich ablaufen: das nächste Issue auswählen, die Freigabe der Spec prüfen, Klasse und Modelle bestimmen, am Ende pushen, den Pull Request anlegen, auf die CI warten und mergen. Solche Schritte muss ein Modell nicht bei jedem Lauf neu lesen und auslegen. Seit Version 3.1 erledigen das zwei Python-Skripte, spec_run_start.py und spec_abschluss.py. Die Claude-Code-Doku beschreibt genau diesen Vorteil: Skripte eines Skills werden ausgeführt, nicht in den Kontext geladen. Die Anleitung von /spec-run ist dadurch von rund 70 KB vor Version 3.0 auf rund 30 KB geschrumpft.
Wie wichtig eine harte Prüfung an dieser Stelle ist, hat mir kurz danach ein Vorfall gezeigt. In einem meiner Projekte meldete Forgejo einen Pull Request als gemergt und schloss das Issue, der Default-Branch rückte aber nicht vor. Die Kette startete das nächste Issue auf einer Grundlage, die es gar nicht gab. Seit Version 3.3 zählt ein Merge deshalb erst, wenn der Merge-Commit tatsächlich auf dem Default-Branch liegt. Sonst hält die Kette an.
Eine kleinere Änderung betrifft das Konzept-Review im vollen Weg. Es gibt höchstens einmal an den architect zurück, danach wird umgesetzt. Offene Punkte prüft der reviewer am Ende ohnehin.
Kontext mit Budget
Das dritte Problem waren die CLAUDE.md-Dateien. Claude Code lädt sie zu Beginn jeder Sitzung. Die Doku empfiehlt weniger als 200 Zeilen je Datei, weil längere Dateien mehr Kontext verbrauchen und schlechter befolgt werden. In den Best Practices steht es noch deutlicher: Aufgeblähte CLAUDE.md-Dateien führen dazu, dass Claude die eigentlichen Anweisungen ignoriert.
Bei mir war jede Festlegung aus jedem Arbeitspaket in einer CLAUDE.md gelandet. Seit Version 3.2 misst das Skript spec_kontext.py die automatisch geladenen Kontextdateien eines Projekts gegen ein Budget: 8 KB für die Root-CLAUDE.md, 12 KB je Schicht und 30 KB für alle Dateien auf einem Pfad. /spec-plan misst bei jeder Planung eines Meilensteins mit. Liegt ein Projekt darüber, hilft der neue Skill /kontext-pflege. Er ordnet jede Regel ein, etwa als weiter gültig, veraltet, doppelt oder in der falschen Schicht, und legt mir den Änderungsvorschlag zur Freigabe vor.
Diese Website war das erste Projekt, das ich so aufgeräumt habe. Die Kontextdateien, die beim Arbeiten an einem Paket geladen werden, sind von 147 auf 24 KB geschrumpft. Allein die CLAUDE.md für den Ordner src/ hatte vorher 110 KB. Verloren ging dabei keine Regel: Selten gebrauchte Festlegungen stehen jetzt wörtlich in eigenen Dateien, auf die die zuständige Schicht verweist.
Was ich mir davon verspreche
Die Änderungen sind erst wenige Tage alt, belastbare Zahlen habe ich noch nicht. Ich erwarte, dass normale Pakete deutlich schneller und günstiger durchlaufen, weil zwei Agenten-Runden wegfallen und Start und Abschluss nicht mehr vom Modell ausgelegt werden. Die Prüfstrenge bleibt gleich, denn Test, Review auf Opus, Gegenprobe und CI laufen unverändert. Ob der leichte Weg dieselbe Qualität liefert, werde ich vor allem an den Bugfixes merken, die nach einem Paket nötig werden.
Quellen
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Anthropic: Building effective agents
- Claude Code: How Claude remembers your project
- Claude Code: Best practices
Ich hoffe, dass ich euch mit diesem Einblick weiterhelfen konnte. Falls ihr selbst mit Claude Code an einem ähnlichen Ablauf arbeitet oder Fragen dazu habt, schreibt mir gerne.
Autor