Wer ein eigenes Monitoring, ein Dashboard oder einen externen Scheduler an die IDMC anbindet, muss wissen, welche Jobs gerade laufen und wie die beendeten ausgegangen sind. Die IDMC bietet dafür vier Schnittstellen. Jede weiß etwas anderes, jede ist unterschiedlich schnell, und zwei davon liefern Zeitstempel, die auf den ersten Blick korrekt aussehen und es nicht sind.
In einem meiner Projekte habe ich alle vier gegen eine produktive Org mit rund 190 Task-Läufen am Tag vermessen. In diesem Artikel zeige ich euch die Ergebnisse. Die runAJobCli, die ich in einem früheren Artikel beschrieben habe, nutzt übrigens für Tasks genau zwei dieser Schnittstellen, den activityMonitor und den activityLog, um auf das Ende eines Jobs zu warten.
Vier Quellen im Überblick
| Schnittstelle | Weiß über | Verzögerung |
|---|---|---|
activityMonitor |
laufende Tasks | sofort |
activityLog |
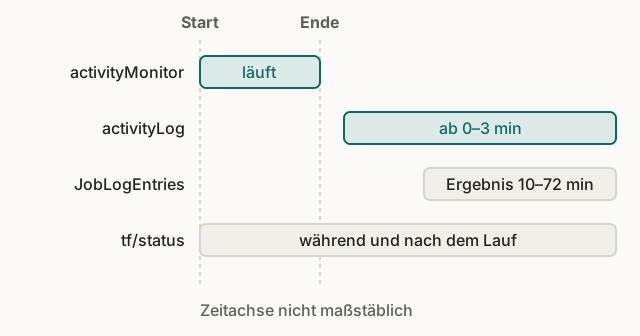
beendete Tasks und Linear Taskflows, keine Taskflows | 0–3 Minuten nach Jobende |
tf/status |
Taskflows samt Subtasks, laufend und beendet | sofort |
JobLogEntries |
beendete Tasks und Taskflows, laufende Tasks | stündlich, 10–72 Minuten |
Keine Quelle deckt alles ab. Ein laufender Taskflow steht zum Beispiel nur in tf/status, ein gerade beendeter Mapping Task in den ersten Minuten nur im activityLog.
Für alle Aufrufe braucht man die Session-ID und die Basis-URL aus dem v3-Login. Wie der Login mit curl funktioniert, habe ich im Artikel über den IPU-Verbrauch gezeigt. Die Beispiele hier setzen die Variablen von dort voraus: SID für die Session und API für die baseApiUrl. Zwei der Dienste hängen nicht unter /saas, sondern direkt am Host:
HOST=${API%/saas}
V2=(-H "icSessionId: $SID" -H "INFA-SESSION-ID: $SID" -H 'Accept: application/json')
activityMonitor und activityLog
Der activityMonitor liefert die gerade laufenden Tasks als Liste:
curl -s "$API/api/v2/activity/activityMonitor" "${V2[@]}" \
  | jq '.[] | {taskName, taskId, runId, startTimeUtc}'
Ist ein Task fertig, verschwindet er dort und taucht innerhalb von null bis drei Minuten im activityLog auf. Der liefert ohne weitere Angabe die letzten 200 Läufe, mit rowLimit höchstens 1000:
curl -s "$API/api/v2/activity/activityLog?rowLimit=200" "${V2[@]}" \
  | jq '.[] | {id, objectName, runId, state, startTimeUtc, endTimeUtc}'
Das Feld state ist eine Zahl: 1 erfolgreich, 2 mit Fehlern, 3 fehlgeschlagen, 4 nicht gestartet. Für einen bestimmten Lauf gibt man taskId und runId gemeinsam als Parameter an, runId allein funktioniert nicht. Taskflows führt der activityLog nicht, nur die älteren Linear Taskflows (Typ WORKFLOW).
Jetzt zur größten Falle. Beide Schnittstellen liefern neben startTimeUtc auch ein Feld startTime, der activityLog außerdem endTime. Ein Wert wie 2026-09-06T22:37:53.000Z sieht aus wie ein ganz normaler Zeitstempel in UTC. Tatsächlich ist es die Uhrzeit an der amerikanischen Ostküste, versehen mit dem Kennzeichen für UTC. Er liegt also im Sommer vier und im Winter fünf Stunden daneben, und kein Parser meldet einen Fehler. Die einzige sichere Regel: aus diesen beiden Schnittstellen ausschließlich startTimeUtc und endTimeUtc lesen.
Taskflows mit tf/status
Für Taskflows gibt es den Status-Dienst unter active-bpel. Die Laufkennung bekommt man beim Start eines Taskflows zurück:
curl -s "$HOST/active-bpel/services/tf/status/$RUN_ID?subtaskDetails=Yes" "${V2[@]}"Die Antwort enthält den Status des Taskflows und unter subtaskDetails die einzelnen Subtasks mit Laufzeit, Zeilenzahlen und Fehlermeldung. Alle Zeitstempel sind hier echtes UTC.
Daneben gibt es eine Suchform mit startTime, endTime und rowLimit, die die Taskflow-Läufe eines Zeitraums liefert. Sie hat einen Haken: Das Feld subtasks nennt zwar die Anzahl der Subtasks, die Liste darunter bleibt aber leer. Die Details bekommt man nur über den Einzelaufruf mit ?subtaskDetails=Yes, also einen Aufruf je Taskflow-Lauf. Außerdem liefert die Suchform ohne Angabe von rowLimit höchstens 10 Läufe und mit rowLimit höchstens 50, weitere holt man mit offset.
Hinweis: Sind die Logs eines Laufs schon gelöscht, antwortet der Dienst laut Dokumentation mit HTTP 200 und {"status":"No status available."}. Wer nur den HTTP-Code prüft, übersieht das.
JobLogEntries
Die umfassendste Quelle ist JobLogEntries im Dienst cdiinsights-service. Sie liefert je Lauf 38 Felder, darunter Ablageort, Laufzeit, Zeilenzahlen, Agent und bei Subtasks einen Verweis auf den übergeordneten Taskflow. Der Aufruf ist eine OData-Abfrage und hat einige Eigenheiten:
ORG=$(echo "$LOGIN" | jq -r '.userInfo.orgId')
curl -s "$HOST/cdiinsights-service/api/v1/analytical/Orgs('$ORG')/JobLogEntries?\$filter=(startTime%20ge%202026-09-14T00:00:00Z)%20and%20(startTime%20le%202026-09-15T00:00:00Z)&\$count=true&\$top=500" \
  -H "IDS-SESSION-ID: $SID" -H 'Accept: application/json' \
  | jq '.value[] | {logEntryId, assetName, assetType, status, startTime, endTime}'
Damit das klappt, müssen vier Dinge gleichzeitig stimmen. Jede Abweichung erzeugt eine Fehlermeldung, die in eine falsche Richtung zeigt:
| Abweichung | Antwort | klingt nach | Ursache |
|---|---|---|---|
Header icSessionId statt IDS-SESSION-ID |
302 auf die Anmeldeseite | falscher Pfad | falscher Header |
| Org-Kennung ohne Hochkommas | 400 The key value '' is invalid. |
falsche Org | fehlende Hochkommas |
Hochkommas als %27 kodiert |
400 The URI is malformed. |
Fehler im Filter | Kodierung |
| 6-stellige statt 22-stellige Org-Kennung | 500 Invalid organization UUID |
Serverfehler | falsche Kennung |
Die richtige Org-Kennung ist die 22-stellige aus userInfo.orgId der Login-Antwort. curl schickt die Hochkommas unverändert, manche HTTP-Bibliotheken kodieren sie dagegen je nach Aufruf zu %27, etwa httpx in Python, wenn man die Parameter als Wörterbuch übergibt. Leerzeichen setzt man selbst als %20.
Hinweis: Die Beispiele in der Dokumentation zeigen den Header icSessionId und Orgs(<orgID>) ohne Hochkommas. Bei meinen Messungen führten genau diese beiden Formen zu den Fehlern oben.
Zwei weitere Eigenheiten betreffen den Inhalt:
- In meinen Messungen wurden die Daten stündlich aufbereitet. Ein Ereignis erscheint etwa 10 bis 12 Minuten nach der nächsten vollen Stunde, also 10 bis 72 Minuten später. Für ein Dashboard mit aktuellem Stand reicht das allein nicht.
- Laut Dokumentation liefert
JobLogEntriesbeendete Jobs. In meiner Org standen laufende Mapping Tasks aber schon mitstatus=RUNNINGdrin und hatten alsendTimeden Platzhalter2038-01-01T00:00:00Z. Ein Filter überendTimefand sie deshalb nie, einer überstartTimeschon. Ist der Lauf beendet, wird derselbe Satz aktualisiert, es entsteht kein zweiter. Laufende Taskflows stehen dagegen erst nach ihrem Ende drin.
Ein unbekannter Wert im Statusfilter, etwa ein Tippfehler, ergibt übrigens keinen Fehler, sondern einfach null Treffer. Eine leere Antwort beweist also nichts.
Wann ein Joblauf in welcher Quelle zu sehen ist, zeigt die folgende Grafik:
Kennungen und Typen
Die Laufkennung runId klingt nach einem eindeutigen Schlüssel, ist aber keiner. Sie zählt je Task hoch, nicht global. In meinen Messungen trugen 1000 Sätze des activityLog nur 87 verschiedene runId. Eindeutig sind id im activityLog und logEntryId in JobLogEntries. Einen Lauf aus dem activityMonitor findet man in den anderen Quellen über das Paar aus taskId und runId.
Noch tückischer ist der Datentyp. In JobLogEntries ist runId ein Text ("783"), im activityLog und in tf/status eine Zahl (783). Ein direkter Vergleich schlägt fehl, ohne dass irgendetwas eine Fehlermeldung ausgibt. Das Ergebnis ist zum Beispiel eine Taskflow-Hierarchie ohne Kinder.
Den übergeordneten Taskflow eines Subtasks findet man in JobLogEntries über parentEntityId. Das Feld ist von Anfang an gesetzt und entspricht der logEntryId des Taskflows. Die Felder parRunId und parLocation taugen dafür nicht. Sie sind während des Laufs leer bzw. kommen in einem anderen Format.
Welche Quelle wofür
Für eine Übersicht der laufenden Tasks nimmt man den activityMonitor, für laufende Taskflows tf/status. Beendete Tasks holt man zeitnah aus dem activityLog, dann aber mit den *Utc-Feldern. Für Auswertungen über Tage und Wochen mit Ablageort und Taskflow-Hierarchie ist JobLogEntries die beste Quelle, sofern die Verzögerung von bis zu einer Stunde nicht stört.
Quellen
- Logs for completed jobs (activityLog) (REST API Reference)
- Logs for running jobs (activityMonitor)
- Monitoring taskflow status with the status resource
- Getting log information (JobLogEntries)
- Session IDs (welcher Header zu welcher Ressource gehört)
Ich hoffe, dass ich euch damit die eine oder andere Stunde Fehlersuche ersparen kann. Falls ihr Fragen dazu habt oder ein eigenes Monitoring für die IDMC aufbauen wollt, schreibt mir gerne.
Autor